Machine learning: qué es y cómo funciona en la práctica
El machine learning no es la parte difícil. La parte difícil es tener un histórico lo bastante ordenado como para que el modelo tenga de dónde aprender.
La subasta de Meta Ads que decide cuánto pagar por tu próximo clic funciona con machine learning. El banco que bloqueó una compra sospechosa en tu tarjeta, también. Y la vitrina de recomendados de aquella tienda que visitaste ayer, igual. Ninguna de esas operaciones se vendió internamente como "proyecto de inteligencia artificial": simplemente tenían datos limpios suficientes para entrenar algo encima.
Así que la pregunta útil no es si tu empresa debería usarlo. Ya lo usa, en cuatro o cinco lugares. La pregunta es dónde está funcionando sin que nadie lo supervise y en qué momento conviene entrenar un modelo propio.
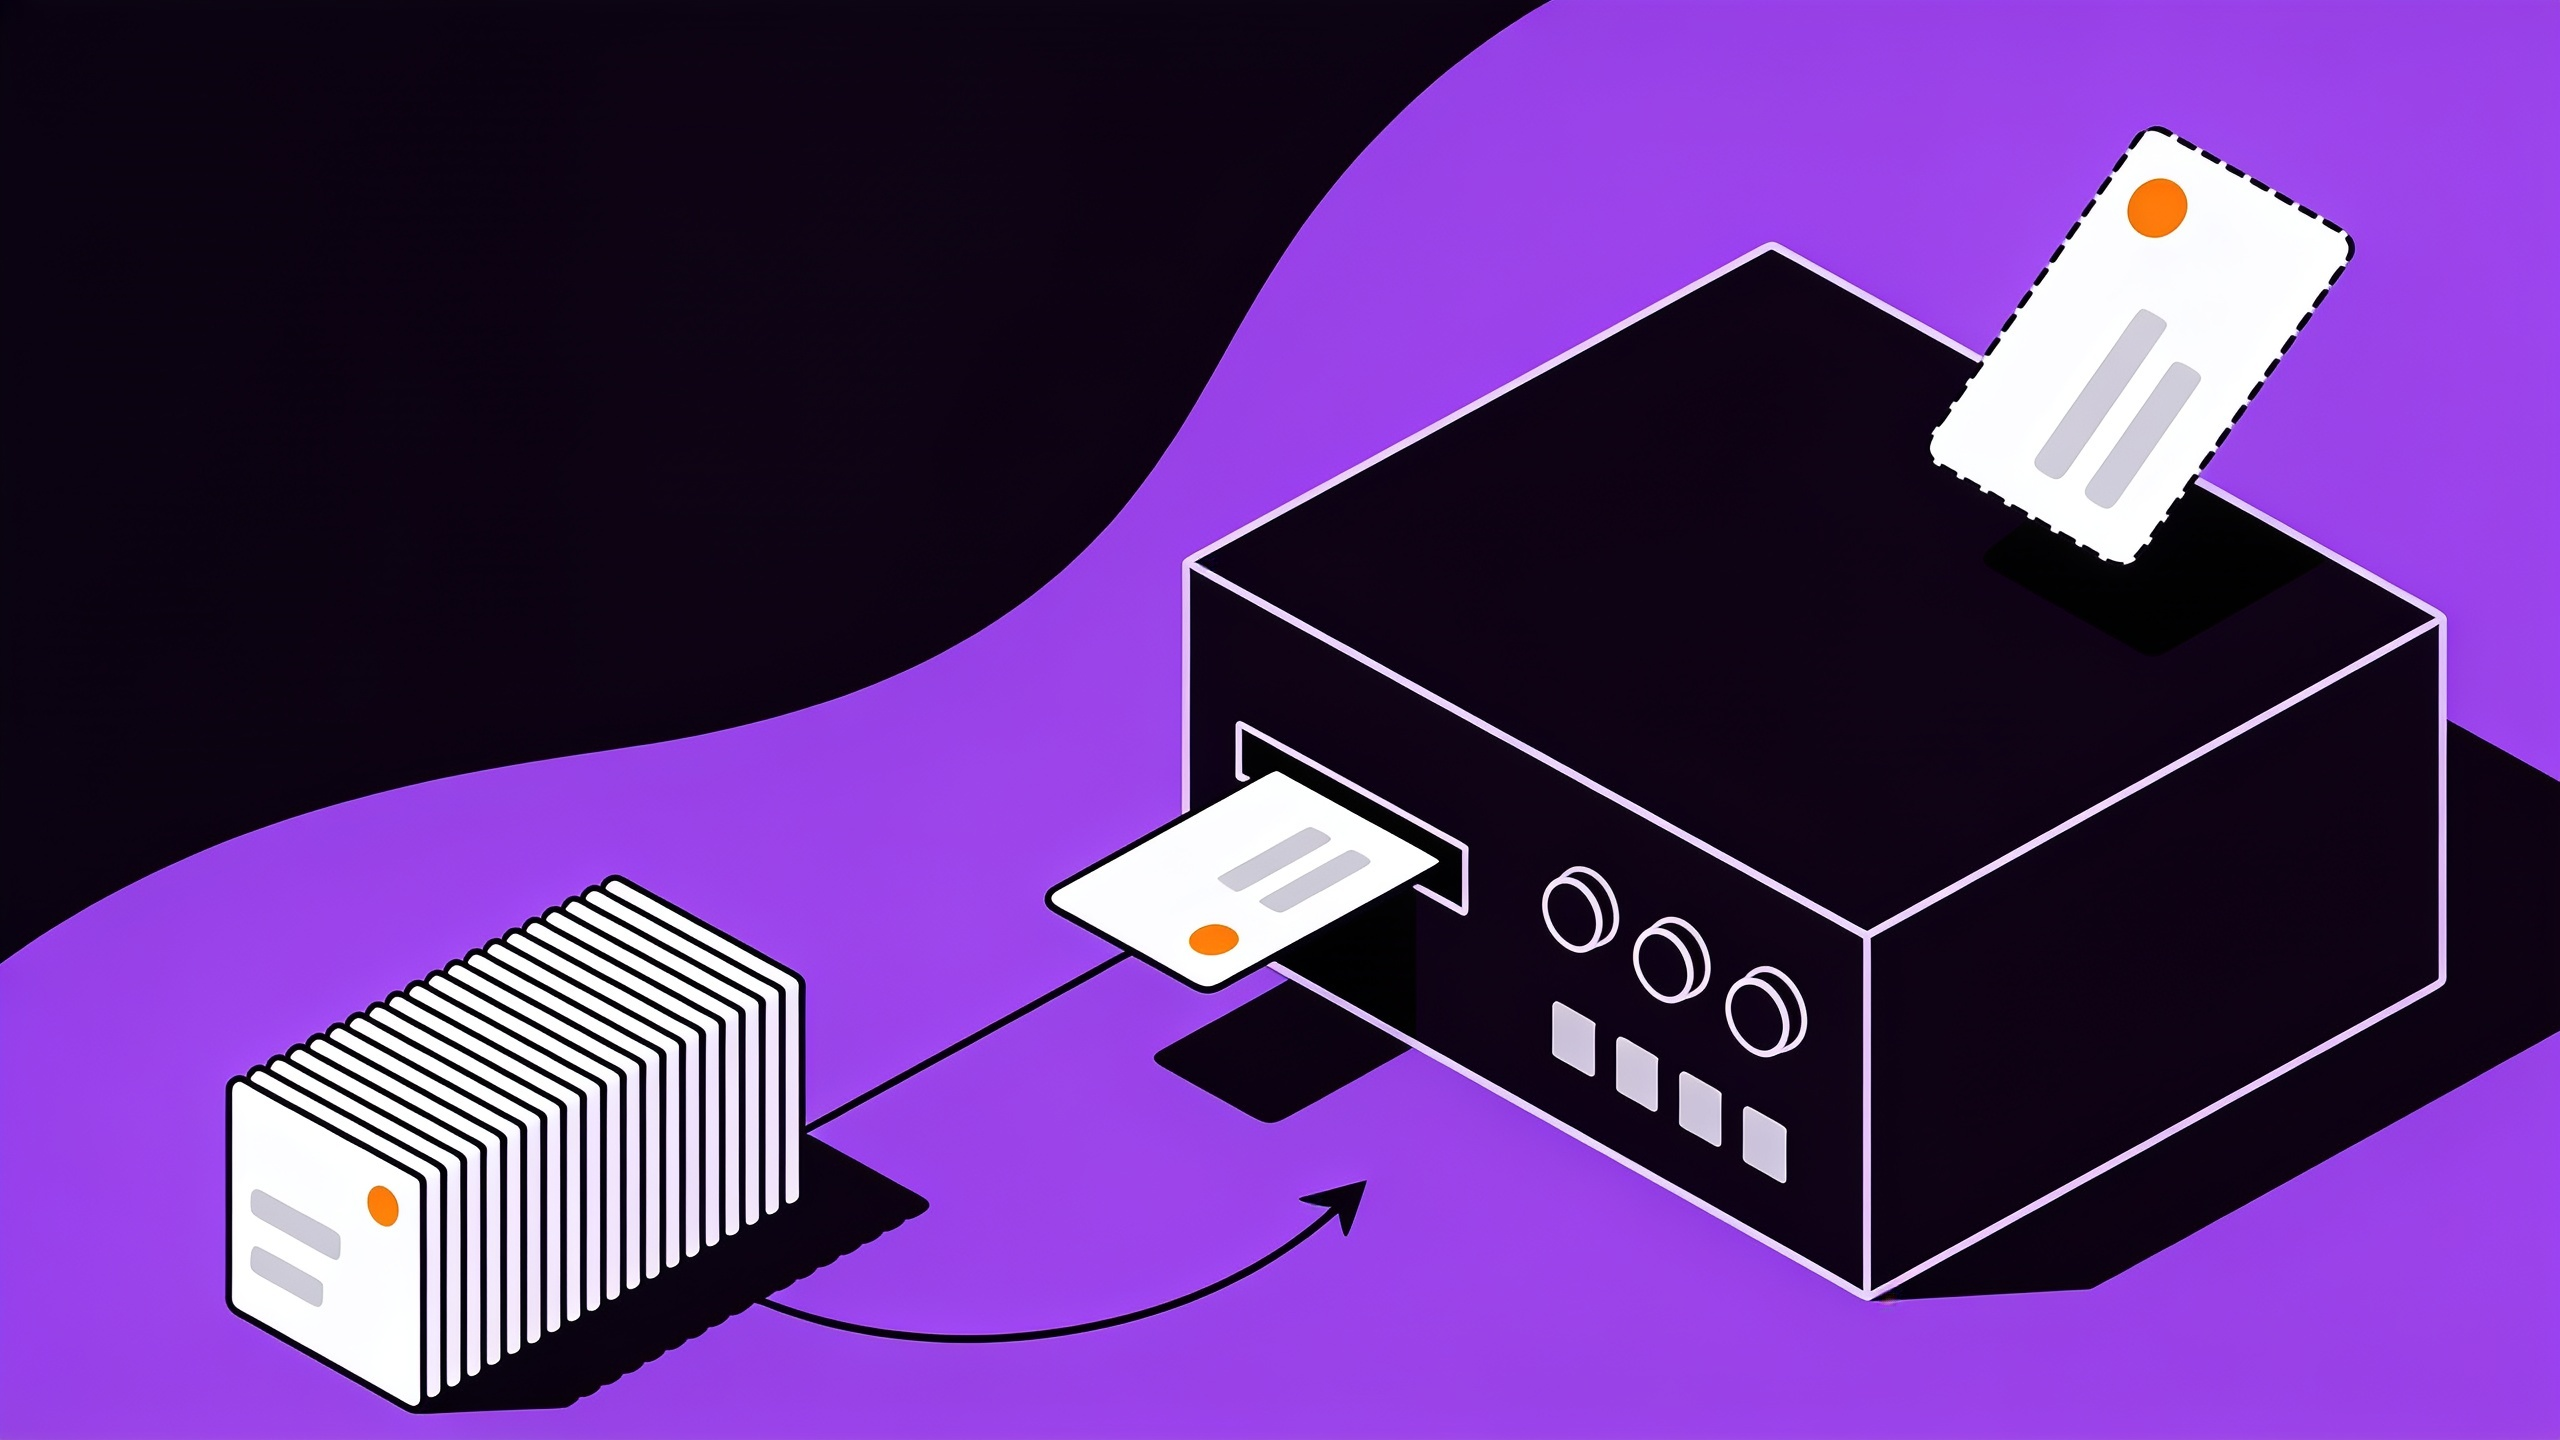
El machine learning, o aprendizaje automático, es el área de la inteligencia artificial en la que el software aprende patrones a partir de ejemplos pasados, en lugar de seguir reglas escritas por una persona. Le muestras miles de casos con el resultado ya conocido, el modelo descubre la relación entre las variables y pasa a estimar el resultado de casos nuevos.
Cómo aprende un modelo de machine learning
La diferencia entre el software tradicional y el machine learning está en quién escribe la regla. En el software tradicional, un analista decide: "si el cliente no accede hace 45 días, márcalo como riesgo de cancelación". En machine learning, nadie elige ese 45. El modelo recorre el histórico y descubre que el número que separa bien a los dos grupos es 38, y que solo importa cuando viene acompañado de una caída de consumo el mes anterior.
El ciclo tiene cuatro etapas.
- Histórico etiquetado. Una tabla donde cada fila es un caso pasado y una de las columnas guarda lo que ocurrió de verdad: canceló o no, compró o no, cuánto gastó.
- Entrenamiento. El modelo intenta prever ese resultado, falla, mide el tamaño del error y ajusta sus pesos internos. Repite eso miles de veces.
- Validación. Apartas una porción del histórico que el modelo nunca vio y pruebas ahí. Es donde se descubre si aprendió el patrón o solo memorizó la base.
- Producción. Llega un caso nuevo, sin resultado conocido, y el modelo devuelve una estimación. Semanas después aparece el resultado real y se convierte en dato de entrenamiento de la siguiente versión.
La cuarta etapa es la más olvidada. Un modelo en producción envejece: el comportamiento del cliente cambia, el mix de producto cambia, el precio cambia. Un modelo entrenado antes de un ajuste de precios sigue respondiendo con la misma seguridad de siempre, solo que equivocado.
¿Cuáles son los tipos de machine learning?
La taxonomía académica tiene variaciones, pero tres categorías cubren casi todo lo que aparece dentro de una empresa.
| Tipo | Qué necesita | Uso típico en el negocio | Dónde suele fallar |
|---|---|---|---|
| Supervisado | Histórico con el resultado registrado caso por caso | Predicción de cancelación, scoring de leads, estimación de demanda | Cuando el resultado nunca se completó bien en el CRM |
| No supervisado | Solo los datos, sin resultado conocido | Segmentación de clientes, detección de gasto anómalo en medios | Genera grupos estadísticamente válidos y comercialmente inútiles |
| Por refuerzo | Un entorno donde el sistema prueba y recibe retorno | Optimización de puja en subastas, precios dinámicos | Exige un volumen alto de intentos antes de aprender algo |
En la práctica, casi todo lo que necesita una empresa media es aprendizaje supervisado. Y el cuello de botella rara vez es el algoritmo: es la columna de resultado. Alguien tiene que haber registrado, caso por caso, qué pasó de verdad. Sin eso no hay nada que aprender, por sofisticada que sea la herramienta.
¿El machine learning es lo mismo que la inteligencia artificial?
No. La inteligencia artificial es el paraguas. El machine learning es el enfoque que domina ese paraguas desde los años 2010. El deep learning es un tipo de machine learning que usa redes neuronales con muchas capas. Y la IA generativa, incluidos los modelos de lenguaje que se volvieron sinónimo de IA en la conversación cotidiana, es una aplicación de deep learning entrenada para producir contenido nuevo.
La distinción que importa en el día a día es de propósito. Un modelo clásico responde "¿qué probabilidad hay de que este cliente cancele en los próximos 30 días?" con un número entre 0 y 1. Un modelo generativo responde "escribe el correo de retención para este cliente". Son trabajos distintos. Confundirlos explica buena parte de la frustración con la IA en las empresas: se le pide una predicción a una herramienta construida para redactar.
Dónde ya funciona el machine learning en tu negocio
En el estudio "Desbloqueando el Potencial de la IA en Brasil 2026", presentado por AWS en septiembre de 2026, cerca de 12 millones de empresas brasileñas dicen usar ya inteligencia artificial, pero el 58% sigue en la etapa básica, aplicándola solo para ganar eficiencia operativa. El acceso dejó de ser el problema. El uso superficial lo es.
Cuatro lugares donde el modelo probablemente ya está encendido en tu operación:
- Pujas automáticas en medios pagos. Maximizar conversiones, ROAS objetivo y las estrategias automáticas de Meta son modelos predictivos que estiman la probabilidad de conversión de cada impresión. Cuando cambias la ventana de atribución, cambias la etiqueta que alimenta a ese modelo. Vale leerlo junto con el orden correcto para analizar campañas de Google Ads.
- Métricas predictivas de GA4. Probabilidad de compra, probabilidad de abandono e ingresos previstos son modelos entrenados con tu propio tráfico. Exigen volumen: según la documentación de Google, la propiedad necesita al menos 1.000 usuarios recurrentes que activaron la condición y 1.000 que no la activaron, en los últimos 28 días. Por debajo de eso la métrica ni aparece, y por eso tantas cuentas nunca vieron ese recurso funcionando. Mira también qué medir de verdad en GA4.
- Antifraude y análisis de crédito. Las pasarelas de pago puntúan cada transacción en milisegundos con modelos supervisados entrenados con contracargos pasados. La etiqueta aquí es cara y lenta, porque un fraude solo se confirma semanas después.
- Previsión de demanda. El comercio y la industria usan series temporales para estimar ventas por artículo y por tienda. Funciona bien con productos de alta rotación y mal con la cola larga, donde el histórico es demasiado corto para formar patrón.
¿Cuándo conviene entrenar un modelo propio?
Tres preguntas, en este orden. ¿La decisión se repite muchas veces al mes? ¿Existe histórico con el resultado registrado? Y sobre todo: ¿la predicción cambia alguna acción concreta? Si la respuesta a la tercera es no, para aquí. Una predicción que no cambia comportamiento es un informe caro.
Conviene mirar el orden de magnitud. Piensa en una operación B2B con 8.000 clientes activos y una cancelación mensual del 3%, es decir, 240 salidas al mes. Supón que el modelo señala con antelación el 60% de ellas: 144 clientes entran en la lista de riesgo cada mes. El equipo comercial trabaja esa lista y revierte el 20% de los casos, 29 clientes. Con un ticket medio de 240 al mes, son unos 7.000 de ingreso recurrente preservado al mes, cerca de 83.000 al año. Esas cifras son una simulación para mostrar el orden de magnitud, no el resultado de una investigación.
Fíjate en lo que exige esa cuenta: alguien tiene que llamar. Si la lista de riesgo llega y nadie actúa, el modelo costó dinero y devolvió un informe bonito. Y la cuenta se rompe entera cuando el motivo de la cancelación es el precio o un competidor más barato, porque entonces la llamada no revierte nada. El modelo acierta quién se va, y los ingresos se van igual. Quien quiera profundizar encontrará más en análisis predictivo en la práctica y en previsión de ventas con IA.
Lo que frena los proyectos no es el algoritmo
Hay un número que aparece en casi toda presentación de un proyecto de machine learning: "nuestro modelo alcanzó un 94% de exactitud". La mayoría de las veces ese número no significa nada. Si solo el 3% de los clientes cancela al mes, un modelo que responde "nadie va a cancelar" para todos acierta el 97% y es completamente inútil. La exactitud sobre una base desequilibrada engaña, y lo que importa es cuántas cancelaciones reales logró pescar el modelo.
El segundo problema es más traicionero. Se llama fuga de datos y ocurre cuando entra en el entrenamiento una información que, en la vida real, solo existe después del resultado. Poner "motivo de la cancelación" entre las variables que predicen la cancelación genera un modelo perfecto en la prueba e inútil en producción, porque en el momento de predecir ese campo todavía está vacío.
El tercero es el más común y el menos glamuroso: registros duplicados, fechas en tres formatos, campos de valor que mezclan coma y punto. El modelo aprende el ruido junto con el patrón. Conviene revisar los errores silenciosos que contaminan tus análisis antes de pensar en entrenar nada.
Preguntas frecuentes
¿El machine learning es lo mismo que la inteligencia artificial?
No. La inteligencia artificial es el campo entero e incluye también sistemas basados en reglas. El machine learning es el conjunto de técnicas en las que el sistema aprende a partir de datos, y hoy representa la mayor parte de lo que el mercado llama IA.
¿Cuál es la diferencia entre machine learning y deep learning?
El deep learning es un subconjunto del machine learning que usa redes neuronales con muchas capas. Brilla con datos no estructurados como imagen, audio y texto. Para datos tabulares, que es lo que tiene la mayoría de las empresas, los modelos más simples suelen dar un resultado igual o mejor, con menos coste y mucha más facilidad para explicarlo.
¿Necesito saber programar para usar machine learning?
Para entrenar un modelo desde cero con control fino, sí, normalmente en Python. Para usar machine learning en decisiones de negocio, no. Las plataformas de anuncios, los CRM y las herramientas de análisis ya incorporan modelos entrenados, y hoy es posible preguntar en lenguaje natural sobre la propia base y recibir el análisis listo.
¿Cuántos datos hacen falta para entrenar un modelo?
Depende del problema, pero el marco útil es contar ejemplos del evento raro, no filas totales. Un millón de pedidos con solo 40 fraudes es una base pobre para antifraude. Como referencia concreta, GA4 solo enciende sus métricas predictivas con 1.000 usuarios a cada lado de la condición en 28 días.
¿Funciona el machine learning en una empresa pequeña?
Funciona siempre que el volumen de decisiones lo justifique. Una empresa con 200 clientes no necesita un modelo de cancelación: el dueño conoce a los 200 por su nombre. El punto de inflexión llega cuando ya nadie puede revisar caso por caso y la decisión pasa a tomarse a ciegas.
Por dónde empezar
El camino que suele funcionar es el contrario al que se imagina. En lugar de elegir un algoritmo y buscar dónde aplicarlo, elige una decisión que tomas a ciegas cada semana e investiga si existe un histórico registrado de ella. En la mayoría de las empresas la respuesta incomoda: el histórico existe, pero está repartido entre la plataforma de anuncios, el CRM y tres hojas de cálculo que no se hablan.
Resolver esa parte rinde más que cualquier modelo sofisticado. Con los datos reunidos en un solo lugar, buena parte de las preguntas que motivarían un proyecto de machine learning ya se responde preguntando en lenguaje natural y recibiendo el análisis listo, que es exactamente lo que hace Sherlok. El modelo predictivo entra después, cuando la pregunta ya está clara y la decisión ya tiene dueño.
¿Quieres ver esto en tus propios datos?
Conecta tus cuentas y haz tu primera pregunta en 5 minutos.
- Sin tarjeta para empezar
- Nada cambia en tus cuentas sin tu aprobación