O que é ETL? Extração, transformação e carga sem jargão
Toda segunda-feira, alguém na sua empresa abre quatro abas: o gerenciador do Meta Ads, o painel do Google Ads, o GA4 e a planilha de vendas. Copia números, cola numa quinta planilha, confere se o total bate com o financeiro. Não bate. Refaz. Duas horas depois, sai um relatório que já nasceu desatualizado.
Esse ritual tem diagnóstico conhecido há décadas: dados espalhados em sistemas que não conversam. E a técnica clássica para resolver isso, mover dados de várias fontes para um lugar só, de forma automática e confiável, atende pela sigla ETL.
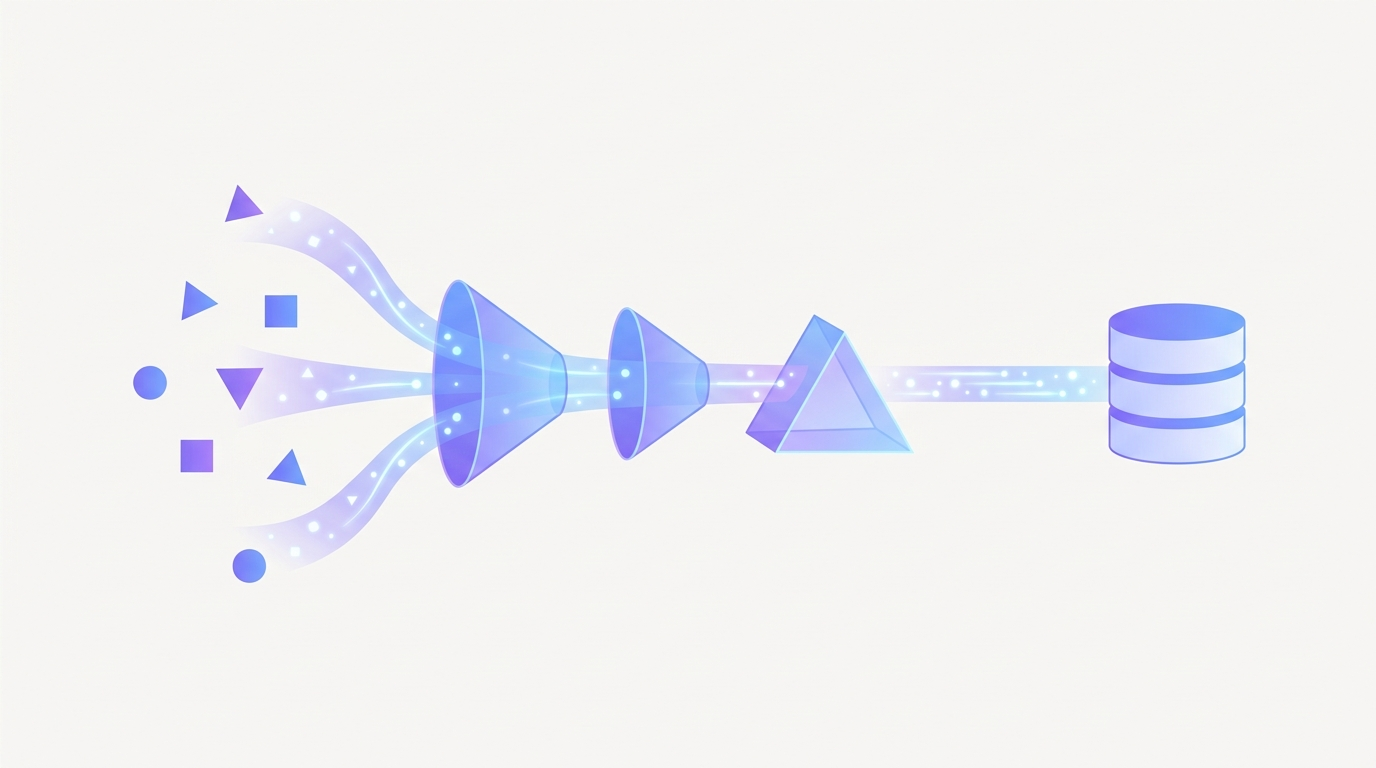
ETL significa Extract, Transform, Load: extrair, transformar e carregar. É o processo que coleta dados de fontes diferentes (CRM, plataformas de anúncio, planilhas, bancos de dados), limpa e padroniza esses dados e os deposita num destino único, em geral um data warehouse, prontos para análise. No ELT, variação mais moderna, a transformação acontece depois da carga, dentro do próprio destino.
O que cada letra do ETL faz na prática
Pense numa cozinha de restaurante. A extração é a ida à feira: você busca os ingredientes onde eles estão. A transformação é o pré-preparo: lavar, descascar, cortar tudo no padrão da casa. A carga é guardar cada item limpo e etiquetado na câmara fria, pronto para virar prato na hora do serviço. Nenhum chef cozinha direto da barraca da feira. Analisar dados direto da fonte crua é a mesma imprudência.
Extração (Extract)
É a coleta dos dados brutos onde eles vivem: a API do Meta Ads, o export do CRM, o banco SQL do ERP, aquela planilha de metas que só o gerente comercial atualiza. A extração pode rodar em lote (todo dia às 6h, por exemplo) ou de forma quase contínua. O desafio aqui é menos técnico e mais de disciplina: cada fonte tem formato, limite de requisições e manias próprias.
Transformação (Transform)
É onde mora o trabalho de verdade. Datas chegam como 12/08/2026 numa fonte e 2026-08-12 na outra. Uma plataforma registra "São Paulo", outra registra "SP". O custo vem em centavos na API e em reais na planilha. O mesmo cliente aparece três vezes com grafias diferentes. A transformação corrige, padroniza, remove duplicatas e cruza tabelas: custo por campanha de um lado, receita por pedido do outro, unidos por um identificador comum.
Carga (Load)
É o depósito do resultado num destino central: um data warehouse como BigQuery ou Snowflake, um banco PostgreSQL, ou até uma planilha mestre em operações menores. A partir daí, dashboards, análises e modelos de IA consultam uma fonte única, com números que batem entre si.
Um exemplo com números reais
Um e-commerce de cosméticos em Recife investe R$ 38.000 no Meta Ads e R$ 22.000 no Google Ads num mês. O gerenciador do Meta reporta R$ 152.000 em receita atribuída (ROAS 4,0). O Google reporta R$ 99.000 (ROAS 4,5). A soma daria R$ 251.000. Mas o faturamento real do site, segundo o ERP, foi de R$ 210.000 no período, contando inclusive vendas orgânicas.
As plataformas não estão mentindo: cada uma atribui a si conversões que a outra também reivindica. Quem olha só os painéis nativos soma dupla contagem e conclui que o ROAS combinado é 4,2. Com um pipeline de ETL cruzando o custo das duas plataformas com os pedidos reais do ERP, a conta muda: R$ 210.000 de receita sobre R$ 60.000 de mídia é um MER de 3,5. A diferença entre 4,2 e 3,5 é a diferença entre escalar o orçamento com folga e escalar no limite da margem.
Esse tipo de distorção é caro no agregado. A Gartner estima que dados de má qualidade custam em média US$ 12,9 milhões por ano às organizações. Sua empresa não precisa ter esse tamanho para sentir a versão proporcional do problema: decisão de orçamento errada é decisão de orçamento errada em qualquer escala.
Qual a diferença entre ETL e ELT?
A ordem das etapas. No ETL clássico, os dados são transformados num servidor intermediário antes de entrar no destino. No ELT, os dados brutos são carregados primeiro e transformados depois, dentro do próprio data warehouse, geralmente com SQL.
O ELT virou padrão de mercado por uma razão econômica: warehouses em nuvem como BigQuery e Snowflake tornaram barato armazenar e processar dados brutos no destino. Guardar o dado cru tem uma vantagem prática que pouca gente valoriza no começo: quando a regra de negócio muda (e ela muda), você reprocessa o histórico inteiro sem precisar extrair tudo de novo.
| ETL | ELT | |
|---|---|---|
| Onde transforma | Antes da carga, em servidor intermediário | Depois da carga, dentro do warehouse |
| Dado bruto preservado | Não, em geral se perde | Sim, fica disponível para reprocessar |
| Quando faz sentido | Dados sensíveis que exigem mascaramento antes da carga (LGPD), destinos com pouca capacidade | Warehouse em nuvem, regras de negócio que mudam, equipes que dominam SQL |
| Ferramentas típicas | Talend, Pentaho, SSIS | Fivetran ou Airbyte + dbt |
Na prática, para a maioria das PMEs essa escolha importa menos do que parece. O que importa é ter os dados unificados e confiáveis; se a transformação roda antes ou depois da carga é detalhe de implementação que sua ferramenta resolve por você.
Quando uma PME realmente precisa de ETL?
Não no primeiro dia. Com uma fonte de dados e meia dúzia de relatórios, planilha resolve. O problema aparece com o crescimento, e costuma dar sinais claros, parecidos com os que listamos em 5 sinais de que sua empresa precisa integrar dados:
- Você cruza manualmente mais de três fontes (anúncios, CRM, financeiro, planilhas) toda semana.
- Montar o relatório mensal consome horas de alguém que custa caro.
- Marketing e financeiro apresentam números diferentes para a mesma métrica na mesma reunião.
- Decisões esperam dias porque "o relatório ainda não ficou pronto".
Há um dado clássico do setor que explica o custo escondido: numa pesquisa da CrowdFlower publicada pela Forbes, profissionais de dados relataram gastar cerca de 80% do tempo coletando, limpando e organizando dados, e só o restante analisando. Quando quem faz isso na sua empresa é um analista de marketing ou o próprio sócio, o desperdício é o mesmo, só que sem o título de "engenheiro de dados" no crachá.
Aqui vale honestidade sobre o caminho tradicional: montar pipeline próprio, com engenheiro de dados, warehouse e ferramentas de orquestração, raramente se paga para quem fatura menos de alguns milhões por ano. É a solução certa para o problema certo no tamanho errado. Os erros mais comuns nessa jornada estão mapeados em principais erros de gestão de dados que travam o crescimento.
Ferramentas de ETL: do script ao clique
O mercado se organiza em três camadas. Na base, ferramentas de código aberto como Airbyte e Meltano: flexíveis, gratuitas na origem, mas exigem alguém técnico para operar. No meio, serviços gerenciados como Fivetran, Stitch e Hevo, que vendem conectores prontos por assinatura e tiram a manutenção das suas costas. No topo, plataformas de análise que já embutem a integração: você conecta as contas e a camada de ETL fica invisível.
Um caso particular que gera dúvida frequente: o Power Query, dentro do Power BI e do Excel, é um mini-ETL de mesa. Ele extrai de várias fontes, transforma com uma interface visual e carrega no modelo do relatório. Para um relatório individual funciona bem; como infraestrutura central da empresa, esbarra em limites de volume, agendamento e governança. Comparamos as opções em melhores ferramentas de análise de dados para empresas.
Perguntas frequentes
Quais são as etapas do processo de ETL?
Três: extração (coletar dados brutos das fontes), transformação (limpar, padronizar, remover duplicatas e cruzar tabelas) e carga (depositar o resultado num destino central, como um data warehouse). Em pipelines reais há também etapas de validação e monitoramento, para detectar quando uma fonte quebra ou muda de formato.
O que é ETL no Power BI?
No Power BI, o papel de ETL é do Power Query: ele conecta a várias fontes, aplica transformações numa interface visual e carrega o resultado no modelo de dados do relatório. É um ETL em escala de relatório, adequado para análises individuais, mas limitado como infraestrutura central de dados da empresa.
ETL serve só para empresas grandes?
Não. O conceito nasceu no mundo corporativo, mas o problema que ele resolve (dados espalhados que não batem entre si) aparece em qualquer empresa com mais de duas ou três fontes de dados. O que muda é a ferramenta: uma PME raramente precisa de pipeline próprio, e sim de uma solução com conectores prontos.
Qual a diferença entre ETL e integração de dados?
Integração de dados é o objetivo: fazer sistemas diferentes conversarem e produzirem uma visão única. ETL (e ELT) é uma das técnicas para chegar lá, focada em análise. Outras técnicas, como APIs de sincronização e virtualização de dados, servem a casos de uso operacionais diferentes.
ETL é a mesma coisa que data warehouse?
Não. O data warehouse é o depósito central onde os dados analíticos ficam armazenados. O ETL é o transporte: o processo que leva os dados das fontes até esse depósito, já limpos e padronizados. Um depende do outro, mas são peças diferentes da mesma arquitetura.
O ETL virou detalhe de implementação. O problema continua sendo seu
Durante vinte anos, "fazer ETL" foi sinônimo de projeto de TI: meses de implantação, consultoria, manutenção eterna. Essa era acabou para quem está do lado da demanda. Conectores prontos e warehouses em nuvem transformaram o ETL em commodity; o que continua raro é a capacidade de fazer boas perguntas aos dados unificados, como discutimos em como conectar marketing, vendas e finanças sem perder tempo.
É essa a aposta do Sherlok: a plataforma conecta Meta Ads, Google Ads, GA4, CRMs, planilhas e bancos SQL, cuida da extração e da padronização por baixo do capô, e deixa você fazer o que gera valor, perguntar em português e receber a análise pronta. Se sua segunda-feira ainda começa com quatro abas abertas e números que não batem, o problema não é falta de esforço. É falta de ETL, trabalhando em silêncio a seu favor.
Quer ver isso nos seus próprios dados?
Conecte suas contas e faça a primeira pergunta em 5 minutos.
- Sem cartão para começar
- Nada muda nas suas contas sem o seu sim