
¿Qué es ETL? Extracción, transformación y carga sin jerga
Cada lunes por la mañana, alguien en tu empresa abre cuatro pestañas: el administrador de Meta Ads, el panel de Google Ads, GA4 y la planilla de ventas. Copia números, los pega en una quinta planilla y verifica si el total coincide con finanzas. No coincide. Lo rehace. Dos horas después, sale un reporte que ya nació desactualizado.
Ese ritual tiene un diagnóstico conocido desde hace décadas: datos dispersos en sistemas que no se hablan entre sí. Y la técnica clásica para resolverlo, mover datos de varias fuentes a un solo lugar de forma automática y confiable, responde a la sigla ETL.
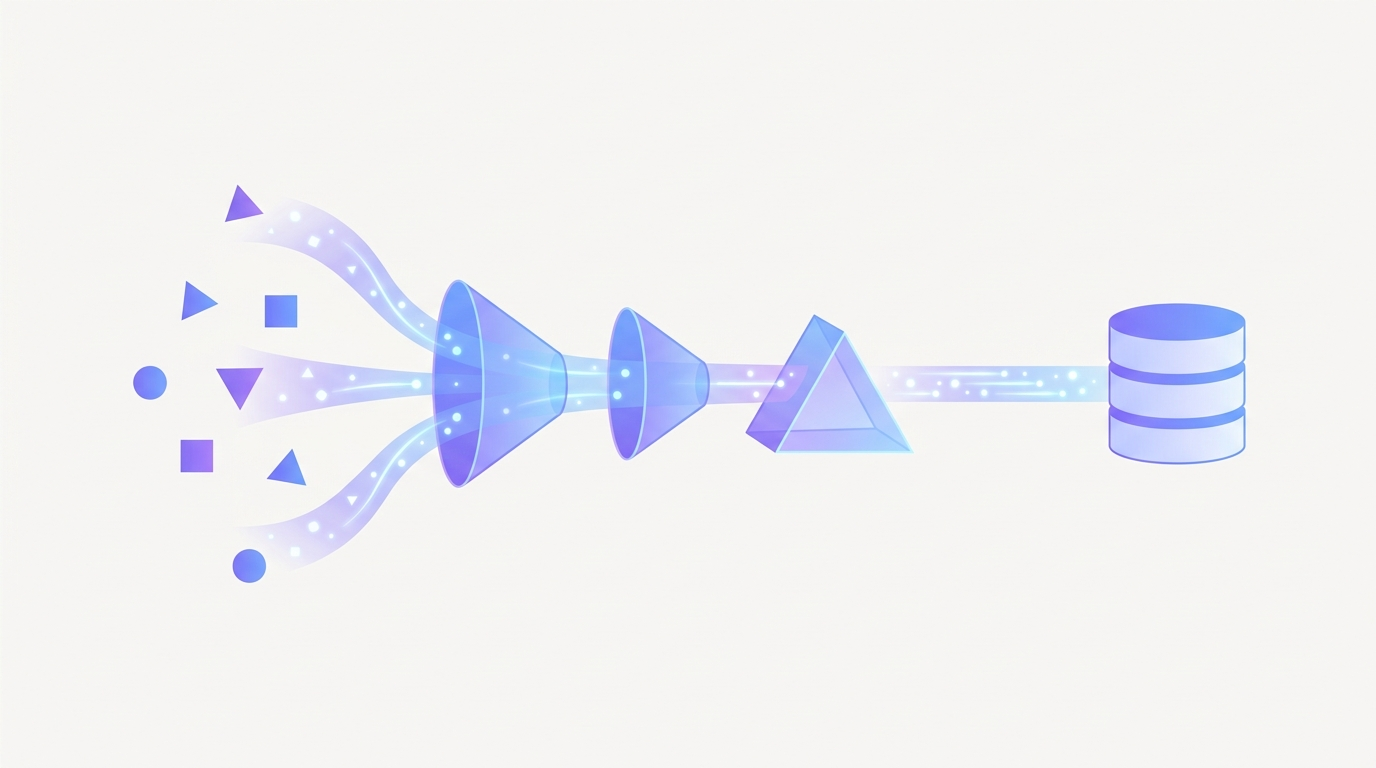
ETL significa Extract, Transform, Load: extraer, transformar y cargar. Es el proceso que recolecta datos de fuentes distintas (CRM, plataformas de anuncios, planillas, bases de datos), los limpia y estandariza, y los deposita en un destino único, por lo general un data warehouse, listos para el análisis. En el ELT, la variante más moderna, la transformación ocurre después de la carga, dentro del propio destino.
Qué hace cada letra del ETL en la práctica
Piensa en la cocina de un restaurante. La extracción es la ida al mercado: buscas los ingredientes donde están. La transformación es la preparación previa: lavar, pelar, cortar todo según el estándar de la casa. La carga es guardar cada ítem limpio y etiquetado en la cámara fría, listo para convertirse en plato durante el servicio. Ningún chef cocina directo desde el puesto del mercado. Analizar datos directo de la fuente cruda es la misma imprudencia.
Extracción (Extract)
Es la recolección de los datos brutos donde viven: la API de Meta Ads, el export del CRM, la base SQL del ERP, esa planilla de metas que solo actualiza el gerente comercial. La extracción puede correr por lotes (todos los días a las 6 de la mañana, por ejemplo) o de forma casi continua. El desafío aquí es menos técnico y más de disciplina: cada fuente tiene su formato, sus límites de peticiones y sus manías.
Transformación (Transform)
Aquí vive el trabajo de verdad. Las fechas llegan como 12/08/2026 en una fuente y 2026-08-12 en otra. Una plataforma registra "Ciudad de México", otra registra "CDMX". El costo viene en centavos desde la API y en unidades monetarias desde la planilla. El mismo cliente aparece tres veces con grafías distintas. La transformación corrige, estandariza, elimina duplicados y cruza tablas: costo por campaña de un lado, ingresos por pedido del otro, unidos por un identificador común.
Carga (Load)
Es el depósito del resultado en un destino central: un data warehouse como BigQuery o Snowflake, una base PostgreSQL o incluso una planilla maestra en operaciones más pequeñas. A partir de ahí, dashboards, análisis y modelos de IA consultan una fuente única, con números que coinciden entre sí.
Un ejemplo con números reales
Una tienda online de cosméticos invierte US$ 38.000 en Meta Ads y US$ 22.000 en Google Ads en un mes. El administrador de Meta reporta US$ 152.000 en ingresos atribuidos (ROAS 4,0). Google reporta US$ 99.000 (ROAS 4,5). La suma daría US$ 251.000. Pero la facturación real del sitio, según el ERP, fue de US$ 210.000 en el período, incluyendo ventas orgánicas.
Las plataformas no mienten: cada una se atribuye conversiones que la otra también reclama. Quien mira solo los paneles nativos suma ingresos contados dos veces y concluye que el ROAS combinado es 4,2. Con un pipeline de ETL que cruza el costo de ambas plataformas con los pedidos reales del ERP, la cuenta cambia: US$ 210.000 de ingresos sobre US$ 60.000 de inversión es un MER de 3,5. La diferencia entre 4,2 y 3,5 es la diferencia entre escalar el presupuesto con holgura y escalar al límite del margen.
Este tipo de distorsión sale cara en el agregado. Gartner estima que los datos de mala calidad cuestan en promedio US$ 12,9 millones al año a las organizaciones. Tu empresa no necesita tener ese tamaño para sentir la versión proporcional del problema: una decisión de presupuesto equivocada lo es en cualquier escala.
¿Cuál es la diferencia entre ETL y ELT?
El orden de las etapas. En el ETL clásico, los datos se transforman en un servidor intermedio antes de entrar al destino. En el ELT, los datos brutos se cargan primero y se transforman después, dentro del propio data warehouse, generalmente con SQL.
El ELT se volvió el estándar del mercado por una razón económica: los warehouses en la nube como BigQuery y Snowflake abarataron almacenar y procesar datos brutos en el destino. Guardar el dato crudo tiene una ventaja práctica que pocos valoran al principio: cuando la regla de negocio cambia (y va a cambiar), reprocesas todo el histórico sin volver a extraer nada.
| ETL | ELT | |
|---|---|---|
| Dónde se transforma | Antes de la carga, en un servidor intermedio | Después de la carga, dentro del warehouse |
| Dato bruto preservado | En general, no | Sí, disponible para reprocesar |
| Cuándo tiene sentido | Datos sensibles que exigen enmascaramiento antes de la carga (leyes de privacidad), destinos con poca capacidad | Warehouse en la nube, reglas de negocio que cambian, equipos que dominan SQL |
| Herramientas típicas | Talend, Pentaho, SSIS | Fivetran o Airbyte + dbt |
En la práctica, para la mayoría de las pymes esta elección importa menos de lo que parece. Lo que importa es tener los datos unificados y confiables; si la transformación corre antes o después de la carga es un detalle de implementación que tu herramienta resuelve por ti.
¿Cuándo necesita ETL una pyme de verdad?
No el primer día. Con una fuente de datos y media docena de reportes, la planilla alcanza. El problema aparece con el crecimiento, y suele dar señales claras, parecidas a las que listamos en 5 señales de que tu empresa necesita integrar sus datos:
- Cruzas manualmente más de tres fuentes (anuncios, CRM, finanzas, planillas) cada semana.
- Armar el reporte mensual consume horas de alguien cuyo tiempo cuesta caro.
- Marketing y finanzas presentan números distintos para la misma métrica en la misma reunión.
- Las decisiones esperan días porque "el reporte todavía no está listo".
Hay un dato clásico del sector que explica el costo escondido: en una encuesta de CrowdFlower publicada por Forbes, los profesionales de datos reportaron dedicar cerca del 80% de su tiempo a recolectar, limpiar y organizar datos, y solo el resto a analizarlos. Cuando quien hace eso en tu empresa es un analista de marketing o el propio socio, el desperdicio es el mismo, solo que sin el título de "ingeniero de datos" en la credencial.
Aquí cabe ser honesto sobre el camino tradicional: montar un pipeline propio, con ingeniero de datos, warehouse y herramientas de orquestación, rara vez se paga para quien factura menos de algunos millones al año. Es la solución correcta para el problema correcto en el tamaño equivocado. Los errores más comunes de ese camino están mapeados en los errores de gestión de datos que frenan el crecimiento.
Herramientas de ETL: del script al clic
El mercado se organiza en tres capas. En la base, herramientas de código abierto como Airbyte y Meltano: flexibles, gratuitas en origen, pero exigen a alguien técnico para operarlas. En el medio, servicios gestionados como Fivetran, Stitch y Hevo, que venden conectores listos por suscripción y te quitan el mantenimiento de encima. En la cima, plataformas de análisis que ya traen la integración incorporada: conectas las cuentas y la capa de ETL se vuelve invisible.
Un caso particular que genera dudas frecuentes: Power Query, dentro de Power BI y Excel, es un mini-ETL de escritorio. Extrae de varias fuentes, transforma con una interfaz visual y carga en el modelo del reporte. Para un reporte individual funciona bien; como infraestructura central de datos de la empresa, choca con límites de volumen, programación y gobernanza. Comparamos las opciones en las mejores herramientas de análisis de datos para empresas.
Preguntas frecuentes
¿Cuáles son las etapas del proceso de ETL?
Tres: extracción (recolectar datos brutos de las fuentes), transformación (limpiar, estandarizar, eliminar duplicados y cruzar tablas) y carga (depositar el resultado en un destino central, como un data warehouse). En pipelines reales también hay etapas de validación y monitoreo, para detectar cuándo una fuente falla o cambia de formato.
¿Qué es ETL en Power BI?
En Power BI, el papel de ETL lo cumple Power Query: se conecta a varias fuentes, aplica transformaciones con una interfaz visual y carga el resultado en el modelo de datos del reporte. Es un ETL a escala de reporte, adecuado para análisis individuales pero limitado como infraestructura central de datos de la empresa.
¿El ETL es solo para empresas grandes?
No. El concepto nació en el mundo corporativo, pero el problema que resuelve (datos dispersos que no coinciden entre sí) aparece en cualquier empresa con más de dos o tres fuentes de datos. Lo que cambia es la herramienta: una pyme rara vez necesita un pipeline propio; necesita una solución con conectores listos.
¿Cuál es la diferencia entre ETL e integración de datos?
La integración de datos es el objetivo: hacer que sistemas distintos se comuniquen y produzcan una visión única. El ETL (y el ELT) es una de las técnicas para lograrlo, enfocada en el análisis. Otras técnicas, como las API de sincronización y la virtualización de datos, sirven para casos de uso operativos distintos.
¿ETL es lo mismo que data warehouse?
No. El data warehouse es el depósito central donde se almacenan los datos analíticos. El ETL es el transporte: el proceso que lleva los datos desde las fuentes hasta ese depósito, ya limpios y estandarizados. Uno depende del otro, pero son piezas distintas de la misma arquitectura.
El ETL se volvió un detalle de implementación. El problema sigue siendo tuyo
Durante veinte años, "hacer ETL" fue sinónimo de proyecto de TI: meses de implementación, consultoría, mantenimiento eterno. Esa era terminó para quien está del lado de la demanda. Los conectores listos y los warehouses en la nube convirtieron el ETL en un commodity; lo que sigue siendo escaso es la capacidad de hacerles buenas preguntas a los datos unificados, como discutimos en cómo conectar marketing, ventas y finanzas sin perder tiempo.
Esa es la apuesta de Sherlok: la plataforma conecta Meta Ads, Google Ads, GA4, CRMs, planillas y bases SQL, se encarga de la extracción y la estandarización tras bambalinas, y te deja hacer lo que genera valor: preguntar en tu idioma y recibir el análisis listo. Si tu lunes todavía empieza con cuatro pestañas abiertas y números que no coinciden, el problema no es falta de esfuerzo. Es la ausencia de un ETL trabajando en silencio a tu favor.
Tus agentes de IA ya saben qué hacer en tu cuenta.
Enciéndelos gratis, sin tarjeta.
- Sin tarjeta
- Acceso de solo lectura
- Lo revocas cuando quieras