Data warehouse: qué es y cuándo necesitas uno
La mitad de las empresas que preguntan por un data warehouse tienen, sumando todo, unas 40.000 filas de datos. Eso cabe en una hoja de cálculo. Cabe incluso en Google Sheets, y sobra espacio.
La otra mitad tiene información repartida en siete sistemas, cierra el mes con tres cifras distintas de facturación y cree que el problema está en el informe. Esa mitad sí lo necesita, pero casi nunca entiende qué está comprando.
Conviene separar las dos conversaciones, porque el error ocurre en ambos sentidos. Quien monta demasiado pronto quema seis meses en una infraestructura que nadie consulta. Quien lo aplaza demasiado decide con números equivocados durante años y solo lo descubre cuando el daño ya es rutina.
¿Qué es un data warehouse?
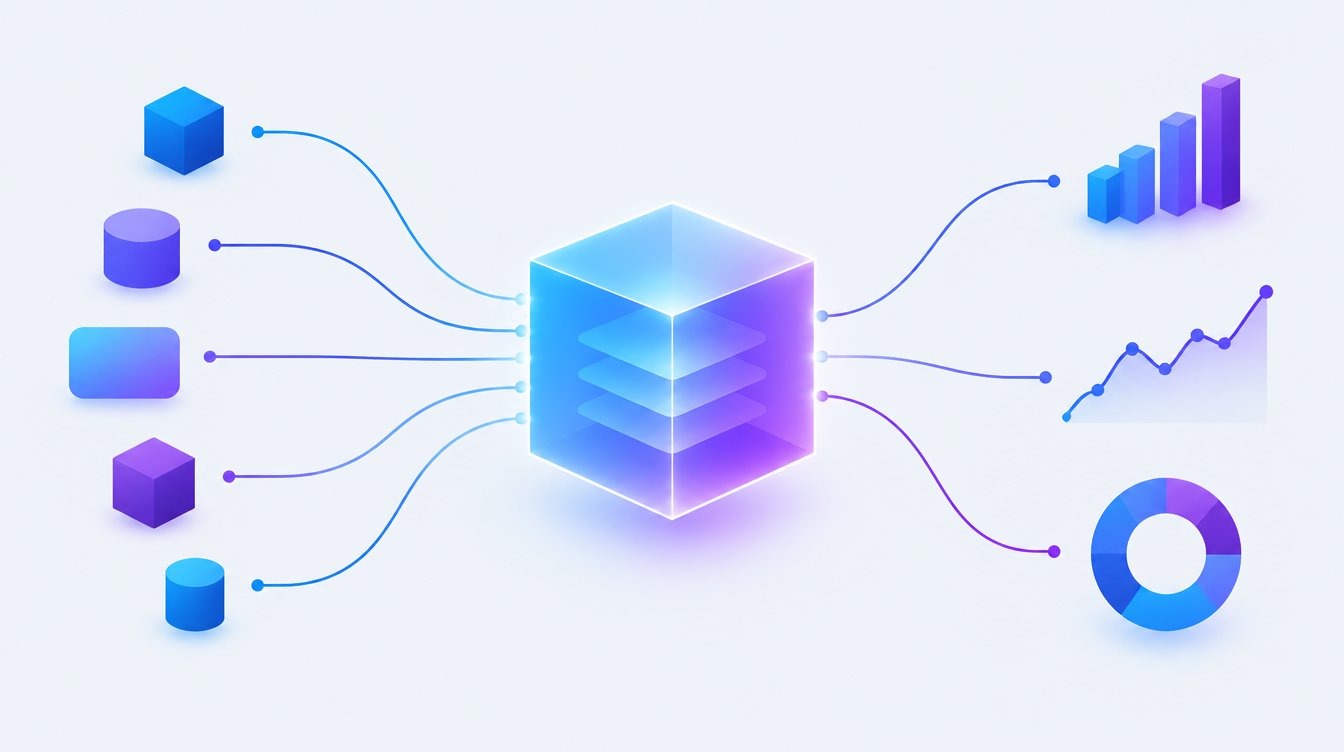
Un data warehouse es una base de datos central, organizada para el análisis, que reúne información de varios sistemas, ERP, CRM, plataformas de anuncios, hojas de cálculo, en un modelo único y con el histórico preservado. No opera el negocio: existe para consultar, comparar periodos y generar informes sin frenar los sistemas de origen.
Esa última parte suele pasarse por alto. Un data warehouse no es "una base de datos más grande". Es una base con otro propósito, y el propósito lo cambia todo: el modelado, la frecuencia de escritura, el tipo de consulta que aguanta.
¿Por qué no basta con la base de datos que ya tienes?
El sistema que emite facturas fue diseñado para grabar una transacción a la vez, rápido y sin perder nada. Es lo que se llama OLTP. Responde de maravilla a "cuál es el saldo del cliente 4.812 ahora mismo" y fatal a "cuál fue el margen por línea de producto, por región, mes a mes, durante tres años".
Cuando alguien lanza la segunda pregunta directo contra producción pasan dos cosas. La consulta se arrastra, porque la estructura nunca se pensó para recorrer millones de registros. Y el sistema se vuelve lento para quien está trabajando, porque la consulta pesada compite con la operación. Al final TI lo prohíbe, y el área de negocio vuelve a exportar en CSV.
Hay además un problema más silencioso: los sistemas operativos sobrescriben el pasado. Si un cliente cambió de categoría en marzo, la base muestra la categoría de hoy. Pierdes la capacidad de responder "cómo estábamos en aquel momento". El data warehouse guarda esas fotografías. Es una de sus razones de ser reales, y casi nunca aparece en las listas de beneficios.
¿Cuándo necesita una empresa un data warehouse?
No hay un número mágico de filas. Lo que suele decidir es la combinación de tres cosas: cuántas fuentes tienen que hablarse, cuánto histórico necesitas mirar hacia atrás y cuánta gente consulta sin pedirle ayuda a nadie.
Señales concretas de que ya llegó el momento:
- Dos áreas presentan cifras distintas para la misma pregunta y nadie sabe cuál es la correcta.
- El informe mensual depende de que una persona concreta junte cinco exportaciones a mano.
- No consigues cruzar la inversión en medios con la venta cerrada porque cada dato vive en otro sitio.
- Ya chocaste con el límite de la hoja de cálculo: se congela, se corrompe o tarda minutos en recalcular.
- Necesitas comparar con el año pasado y el sistema de origen ya sobrescribió ese estado.
Señales de que todavía no toca: tienes dos fuentes, la operación entera cabe en una exportación semanal y el dolor real es la falta de disciplina al registrar, no la falta de tecnología. Un warehouse no arregla un registro mal hecho: solo reparte el error más rápido, a más gente y con más autoridad. Antes de invertir, atiende la calidad de los datos en el origen.
Data warehouse, data lake y lakehouse: ¿cuál es la diferencia?
Los tres guardan datos, pero parten de supuestos distintos sobre cuándo se organiza la información.
| Característica | Data warehouse | Data lake | Lakehouse |
|---|---|---|---|
| Formato | Estructurado, modelado antes de cargar | Crudo, tal como llegó | Crudo con una capa estructurada encima |
| Quién lo usa a diario | Analistas y áreas de negocio | Ingeniería y ciencia de datos | Ambos perfiles |
| Coste de almacenamiento | Mayor por GB | Menor por GB | Intermedio |
| Riesgo típico | Rigidez: cambiar el modelo cuesta | Volverse un depósito sin catálogo | Complejidad operativa |
| Encaja en | La mayoría de empresas medianas | Volumen alto y dato no estructurado | Equipos con ingeniería dedicada |
Una opinión de quien ya vio esto salir mal: si tu empresa no tiene a alguien dedicado a ingeniería de datos, el data lake acaba siendo una carpeta compartida con nombre bonito. Empieza por el warehouse, que obliga a organizar, y migra solo si el volumen o el tipo de dato lo exigen.
¿Cuánto cuesta un data warehouse en la práctica?
La factura de infraestructura asusta bastante menos de lo que se imagina. En BigQuery, Google cobra 6,25 dólares por tebibyte consultado, con el primer 1 TiB de consultas y los primeros 10 GiB de almacenamiento gratis cada mes, según la tabla oficial de precios.
Un ejemplo calculado. Una distribuidora con 3 millones de filas de ventas, 800.000 registros de CRM y dos años de datos de medios ocupa algo cercano a 8 GB, dentro del tramo gratuito de almacenamiento. Si el equipo lanza consultas que recorren 200 GB al mes, sigue por debajo del 1 TiB gratuito. Coste de infraestructura: cero o casi.
El coste real está en otro sitio: quién lo construye y quién lo mantiene. La rutina de ETL necesita responsable. La API de la plataforma de anuncios cambia, el campo de categoría gana un valor nuevo, el ERP se actualiza y la carga se rompe un viernes. Presupuestar el warehouse sin presupuestar el mantenimiento es la forma más común de tener un proyecto muerto en doce meses: las tablas ahí, desactualizadas, y todo el mundo de vuelta al CSV.
Conviene recordar el tamaño del daño del lado contrario. Gartner estima que los datos de mala calidad cuestan a las organizaciones al menos 12,9 millones de dólares al año de media, según lo publicado en el sitio de la propia consultora. No es tu cifra, corresponde a grandes organizaciones, pero la proporción suele mantenerse: equivocarse al decidir sale más caro que la estructura.
Cómo salir de la hoja de cálculo sin atascar el proyecto
El orden importa más que la herramienta. Un camino que funciona:
- Elige una pregunta de negocio, no un conjunto de tablas. "Cuál es el CAC por canal, por mes" es un alcance. "Centralizar los datos de la empresa" no lo es.
- Trae solo las fuentes que responden esa pregunta. Dos, tres como mucho. Resiste la tentación de conectarlo todo.
- Modela con los nombres que usa el negocio. Si comercial dice "oportunidad ganada", la tabla no debería llamarse stage_id_7.
- Automatiza la carga antes de hacer el dashboard bonito. Un dashboard con datos viejos es peor que una hoja de cálculo, porque parece fiable.
- Solo después ábrelo a otras áreas. Cada área nueva trae reglas de negocio nuevas, y es mejor descubrirlo con la estructura ya estable.
Con ese recorte resuelves el síntoma más caro de los datos en silos (cifras que nunca cuadran entre áreas) sin necesitar un proyecto de doce meses para empezar a entregar valor.
Los errores que matan el proyecto a mitad de camino
El primero es empezar por la herramienta. La reunión se convierte en Snowflake contra BigQuery contra Redshift antes de que alguien defina qué decisión va a apoyar el warehouse. Para la mayoría de empresas medianas las tres sirven; la elección cambia poco el resultado y retrasa mucho el arranque.
El segundo es replicar el desorden. Si vuelcas las tablas del ERP dentro del warehouse sin modelar, compraste una copia más cara de la misma confusión. El trabajo de traducción, de estructura de sistema a estructura de negocio, es lo que genera valor.
El tercero es subestimar la rutina. Una encuesta de Anaconda a profesionales de datos indicó que, de media, el 45% de su tiempo se va en preparar datos (cargarlos y limpiarlos) antes de cualquier análisis, según el State of Data Science 2020. El warehouse reduce ese porcentaje, pero traslada parte del esfuerzo al mantenimiento de la carga. Quien no lo planifica vive la ilusión de haber terminado el día en que salió el primer dashboard.
Preguntas frecuentes
¿Un data warehouse es una base de datos?
Técnicamente sí, pero con otra finalidad. Una base operativa está optimizada para grabar transacciones rápido; el warehouse, para leer grandes volúmenes y cruzar dimensiones. La tecnología puede parecerse, el modelado y el patrón de uso no.
¿Cuál es la diferencia entre data warehouse y data lake?
El warehouse organiza el dato antes de guardarlo; el lake guarda primero y organiza después. En la práctica el warehouse da respuestas más rápidas a perfiles de negocio, y el lake ofrece más flexibilidad a ingeniería. Las empresas medianas suelen funcionar mejor empezando por el warehouse.
¿Una pequeña empresa necesita un data warehouse?
En la mayoría de los casos, no de inmediato. Mientras la operación quepa en dos o tres fuentes y una persona pueda consolidarla en un día, basta con una hoja de cálculo o una base simple con BI. El punto de inflexión suele llegar cuando el tiempo de consolidación se vuelve recurrente y las versiones empiezan a divergir.
¿Cuánto se tarda en implementar un data warehouse?
Con un alcance ajustado (dos fuentes y una pregunta de negocio clara), de cuatro a ocho semanas hasta el primer resultado utilizable. Los proyectos que prometen centralizarlo todo de golpe suelen pasar de seis meses y perder el patrocinio antes de entregar.
¿Hace falta un perfil de datos para mantenerlo?
Alguien tiene que hacerse cargo de la carga, aunque sea a tiempo parcial. Las herramientas gestionadas quitan buena parte del trabajo de infraestructura, pero los cambios en las fuentes siguen rompiendo rutinas. Sin responsable definido, la base envejece y el equipo deja de confiar en ella.
La decisión que importa no es técnica
La pregunta que vale la pena hacerse no es "qué data warehouse elegimos", sino "qué decisión venimos tomando a ciegas y cuánto nos está costando". Si la respuesta es una reunión mensual donde cada área trae una cifra distinta, la estructura se paga rápido. Si es curiosidad de dashboard, sale cara para el retorno.
Centralizar datos solo rinde cuando las personas pueden preguntarles cosas. Esa es justo la brecha que cubre Sherlok: conectar las fuentes que ya tienes (anuncios, CRM, hojas de cálculo, bases SQL) y dejar que cualquiera del equipo pregunte en lenguaje natural y reciba el análisis hecho, en lugar de entrar en la cola del equipo técnico. Sirve como primer paso, incluso para descubrir qué preguntas justifican un warehouse más adelante.
Tus agentes de IA ya saben qué hacer en tu cuenta.
Enciéndelos gratis, sin tarjeta.
- Sin tarjeta
- Acceso de solo lectura
- Lo revocas cuando quieras